Engenharia de desempenho com Python 3.12
Table of Contents
3.12 traz perfis de desempenho! Reserve um segundo para conferir https://docs.python.org/3.12/howto/perf_profiling.html e, de fato, o changelog em https://www.python.org/downloads/release/python-3120a3/
A parte importante (para este post) dos links acima é:
""" O Linux perf profiler é uma ferramenta muito poderosa que permite criar perfis e obter informações sobre o desempenho de seu aplicativo. O perf também possui um ecossistema muito vibrante de ferramentas que auxiliam na análise dos dados que ele produz.
O principal problema de usar o perf profiler com aplicativos Python é que perf só permite obter informações sobre símbolos nativos, ou seja, os nomes das funções e procedimentos escritos em C. Isso significa que os nomes e nomes de arquivos das funções Python em seu código não aparecerá na saída do perf.
Desde o Python 3.12, o interpretador pode ser executado em um modo especial que permite que as funções do Python apareçam na saída do perf profiler. Quando este modo está habilitado, o interpretador irá interpor um pequeno pedaço de código compilado em tempo real antes da execução de cada função Python e ensinará perf a relação entre este pedaço de código e a função Python associada usando arquivos de mapa perf. """
escrevendo um programa “ruim”⌗
Estou animado para tentar isso, então vamos em frente. Em primeiro lugar, vamos criar um script python para criarmos o perfil. Estou fazendo isso antes de instalar o Python 3.12, pois quero criar um FlameGraph de como esse processo se parece em 3.10 versos 3.12. Aqui temos um script que tenta realizar pesquisas em uma lista grande:
import time


def run_dummy(numbers):
    for findme in range(100000):
        if findme in numbers:
            print("encontrou", findme)
        else:
            print("perdeu", findme)


if __name__ == "__main__":
    # create a large sized input to show off inefficiency
    numbers = [i for i in range(20000000)]

    start_time = time.time()  # get the current time [start]
    run_dummy(numbers)  # run our inefficient method
    end_time = time.time()  # get the current time [end]

    duration = end_time - start_time  # Calculate the duration
    print(f"Duração: {duration} segundos") # Imprime a duração
Executando isso obtenho o seguinte resultado:
python3.10 assets/dummy/perf_py_proj/before.py
...
found 99992
found 99993
found 99994
found 99995
found 99996 found 99997 found 99998
found 99999
Duração: 36.06884431838989 segundos
36 segundos é ruim o suficiente para coletarmos uma quantidade razoável de amostras.
flamógrafos!⌗
Agora podemos criar nosso FlameGraph:
# grava o perfil no arquivo "perf.data" (saída padrão)
perf record -F 99 -g -- python3.10 assets/dummy/perf_py_proj/before.py
# leia perf.data (criado acima) e exiba a saída do rastreamento
perf script > out.perf
# dobre as amostras da pilha em linhas únicas
# aqui eu faço referência a ~/FlameGraph/ - você pode obter isso em https://github.com/brendangregg/FlameGraph
~/FlameGraph/stackcollapse-perf.pl out.perf > out.folded
# gerar gráfico de chama
~/FlameGraph/flamegraph.pl out.folded > ./assets/perf_example_python3.10.svg
Isso nos dá um bom SVG que visualiza os traços:
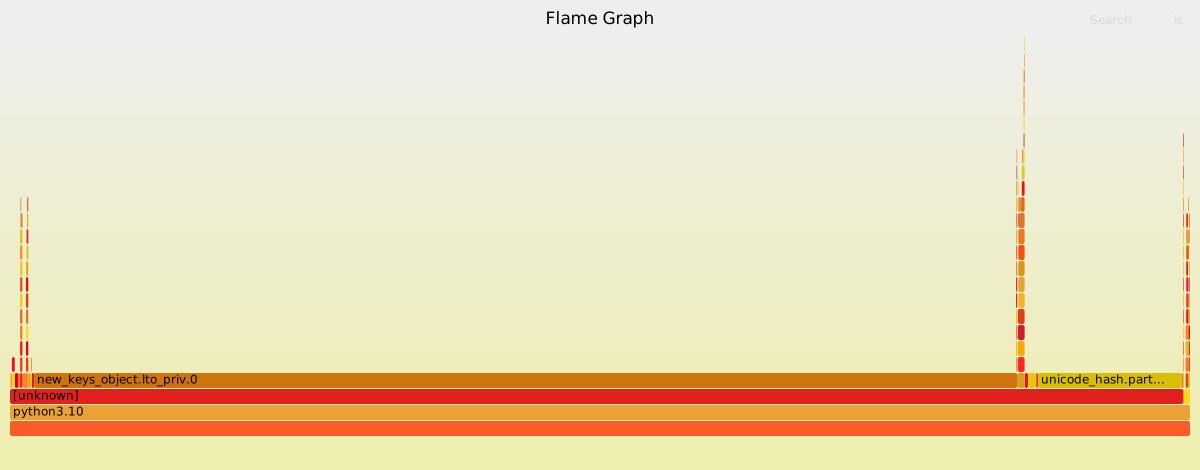
Isso não é útil … Posso ver que a maior parte do tempo foi gasto em “new_keys_object.lto_priv.0”, mas isso não faz sentido no contexto do código.
Hora do Python 3.12…⌗
Primeiro, preciso instalá-lo - as etapas variam dependendo do sistema operacional - siga as instruções de compilação aqui para o seu ambiente: https://github.com/python/cpython/tree/v3.12.0a3#build-instructions
# para mim no ubuntu:22.04
# certifique-se de ter o python3-dbg instalado
sudo apt-get install python3-dbg

# construir python
export CFLAGS="-fno-omit-frame-pointer -mno-omit-leaf-frame-pointer"
./configure --enable-optimizations
make
make test
sudo make install
unset CFLAGS

# depois disso, redefino o link simbólico python3 do meu sistema para 3.10, pois o 3.12 ainda não é estável
# para testar python3.12 chamarei "python3.12" em vez de "python3"
ln -sf /usr/local/bin/python3.10 /usr/local/bin/python3
Com isso instalado, primeiro preciso habilitar o suporte perf. Isso é detalhado em https://docs.python.org/3.12/howto/perf_profiling.html e há três opções: 1) uma variável de ambiente, 2) uma opção -X ou 3) usando sys dinamicamente. Vou optar pela abordagem da variável de ambiente, pois não me importo de tudo ser profarquivado para um pequeno script:
export PYTHONPERFSUPPORT=1
Agora simplesmente repetimos o processo acima usando o binário python3.12:
# grava o perfil no arquivo "perf.data" (saída padrão)
perf record -F 99 -g -- python3.12 assets/dummy/perf_py_proj/before.py
# leia perf.data (criado acima) e exiba a saída do rastreamento
perf script > out.perf
# dobre as amostras da pilha em linhas únicas
# aqui eu faço referência a ~/FlameGraph/ - você pode obter isso em https://github.com/brendangregg/FlameGraph
~/FlameGraph/stackcollapse-perf.pl out.perf > out.folded
# gerar gráfico de chama
~/FlameGraph/flamegraph.pl out.folded > ./assets/perf_example_python3.12.before.svg
Primeiro, daremos uma olhada no relatório com perf report -g -i perf.data
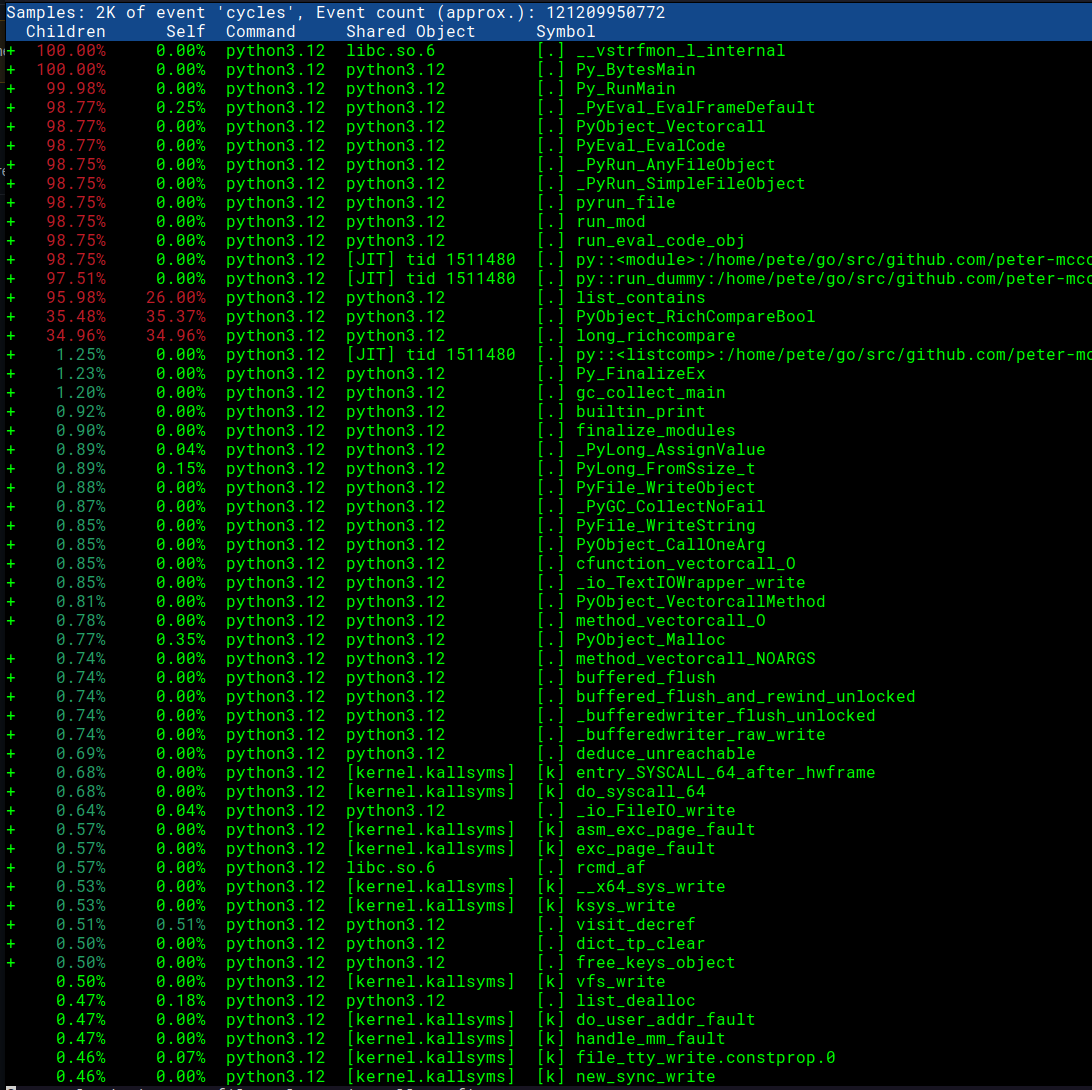
Impressionante! Podemos ver nossos nomes de função Python e nomes de script!
Agora podemos dar uma olhada no SVG atualizado que visualiza os traços com o Python 3.12:
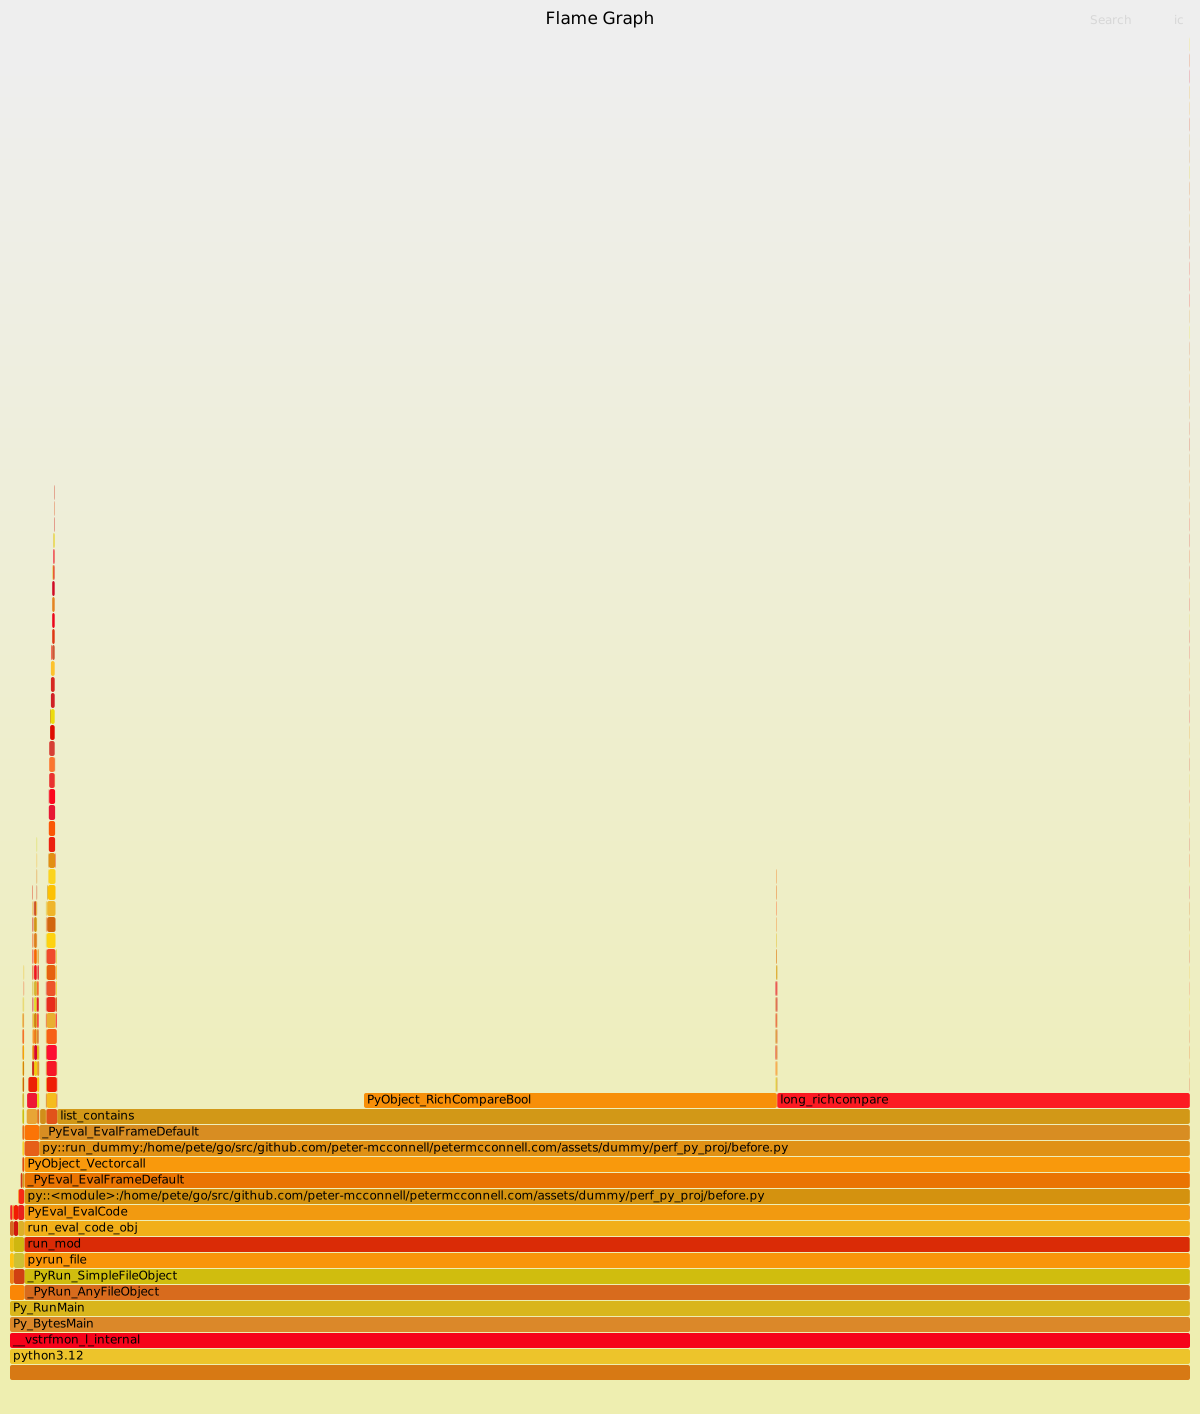
Isso já parece muito mais útil. Vemos que a maior parte do tempo está sendo gasto fazendo comparações e no método list_contains. Também podemos ver o arquivo específico before.py e o método run_dummy que o está chamando.
Tempo de investigação / a correção⌗
Agora que sabemos onde está o problema em nosso código, podemos dar uma olhada no código-fonte em CPython para ver por que o método list_contains seria tão lento: https://github.com/python/cpython/blob/ 199507b81a302ea19f93593965b1e5088195a6c5/Objects/listobject.c#L440
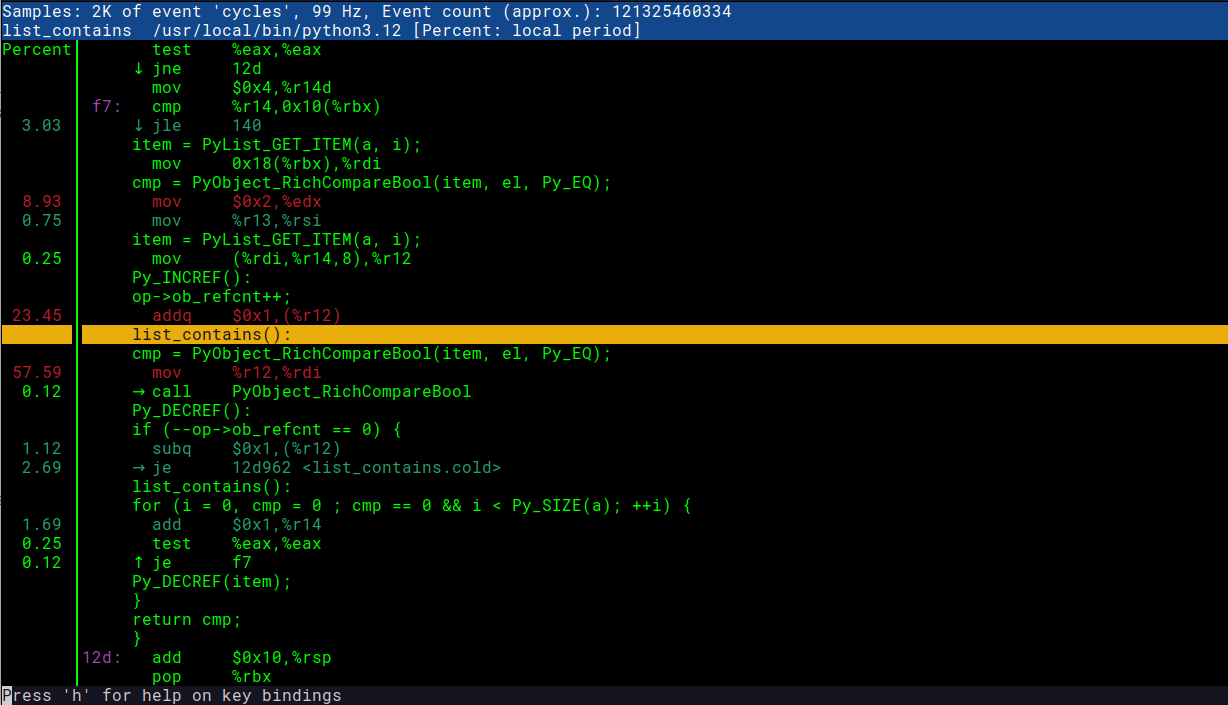
observação: nem sempre você tem acesso ao código-fonte - em circunstâncias como essa, você pode visualizar a desmontagem no relatório perf diretamente para ter uma ideia do que está acontecendo. Vou adicionar uma seção rápida no final mostrando como isso parece
// Encontrei isso acessando https://github.com/python/cpython/ e procurando por "list_contains"

static int
list_contains(PyListObject *a, PyObject *el)
{
    PyObject *item;
    Py_ssize_t i;
    int cmp;

    for (i = 0, cmp = 0 ; cmp == 0 && i < Py_SIZE(a); ++i) {
        item = PyList_GET_ITEM(a, i);
        Py_INCREF(item);
        cmp = PyObject_RichCompareBool(item, el, Py_EQ);
        Py_DECREF(item);
    }
    return cmp;
}
Desagradável … olhando para este código, posso ver que cada vez que é invocado, ele itera sobre a matriz e executa uma comparação com cada item. Isso está longe de ser ideal para nosso caso de uso, então vamos voltar ao código Python que escrevemos. Nosso Flamegraph nos mostra que o problema está em nosso método run_dummy:
def run_dummy(numbers):
    for findme in range(100000):
        if findme in numbers:  # <- é isso que aciona list_contains
            print("encontrou", findme)
        else:
            print("perdeu", findme)
Não podemos realmente alterar essa linha, pois ela está fazendo o que queremos - identificando se um inteiro está em numbers. Talvez possamos mudar o tipo de dados numbers para um mais adequado para pesquisas. Em nosso código existente, temos:
    numbers = [i for i in range(20000000)]

    start_time = time.time()  # obtém a hora atual [start]
    run_dummy(numbers)  # executa nosso método ineficiente
Aqui, usamos um tipo de dados LIST para nossos “números”, que sob o capô (no CPython) é implementado como arrays de tamanho dinâmico e, como tal, não é nem de longe tão eficiente (O(N)) quanto os gostos de um Hashtable para procurar um item (que é O(1)). Por outro lado, um SET (outro tipo de dados do Python) é implementado como um Hashtable e nos daria a pesquisa rápida que estamos procurando. Vamos alterar o tipo de dados em nosso código Python e ver qual é o impacto:
    # vamos apenas mudar esta linha, convertendo números em um conjunto antes de executar run_dummy
    run_dummy(set(numbers))  # passando um set() para pesquisas rápidas
Agora podemos repetir os passos acima para gerar nosso novo flamegraph:
# grava o perfil no arquivo "perf.data" (saída padrão)
perf record -F 99 -g -- python3.12 assets/dummy/perf_py_proj/after.py
...
encontrado 99998
encontrado 99999
Duração: 0.8350753784179688 segundos
[ perf record: Woken up 1 times to write data ]
[ perf record: Captured and wrote 0.039 MB perf.data (134 samples) ]
Já podemos ver que as coisas melhoraram enormemente. Onde antes isso levava 36 segundos para ser executado, agora leva 0,8 segundos! Vamos continuar criando nosso flamegraph para o novo código aprimorado:
# leia perf.data (criado acima) e exiba a saída do rastreamento
perf script > out.perf
# dobre as amostras da pilha em linhas únicas
# aqui eu faço referência a ~/FlameGraph/ - você pode obter isso em https://github.com/brendangregg/FlameGraph
~/FlameGraph/stackcollapse-perf.pl out.perf > out.folded
# gerar gráfico de chama
~/FlameGraph/flamegraph.pl out.folded > ./assets/perf_example_python3.12.after.svg
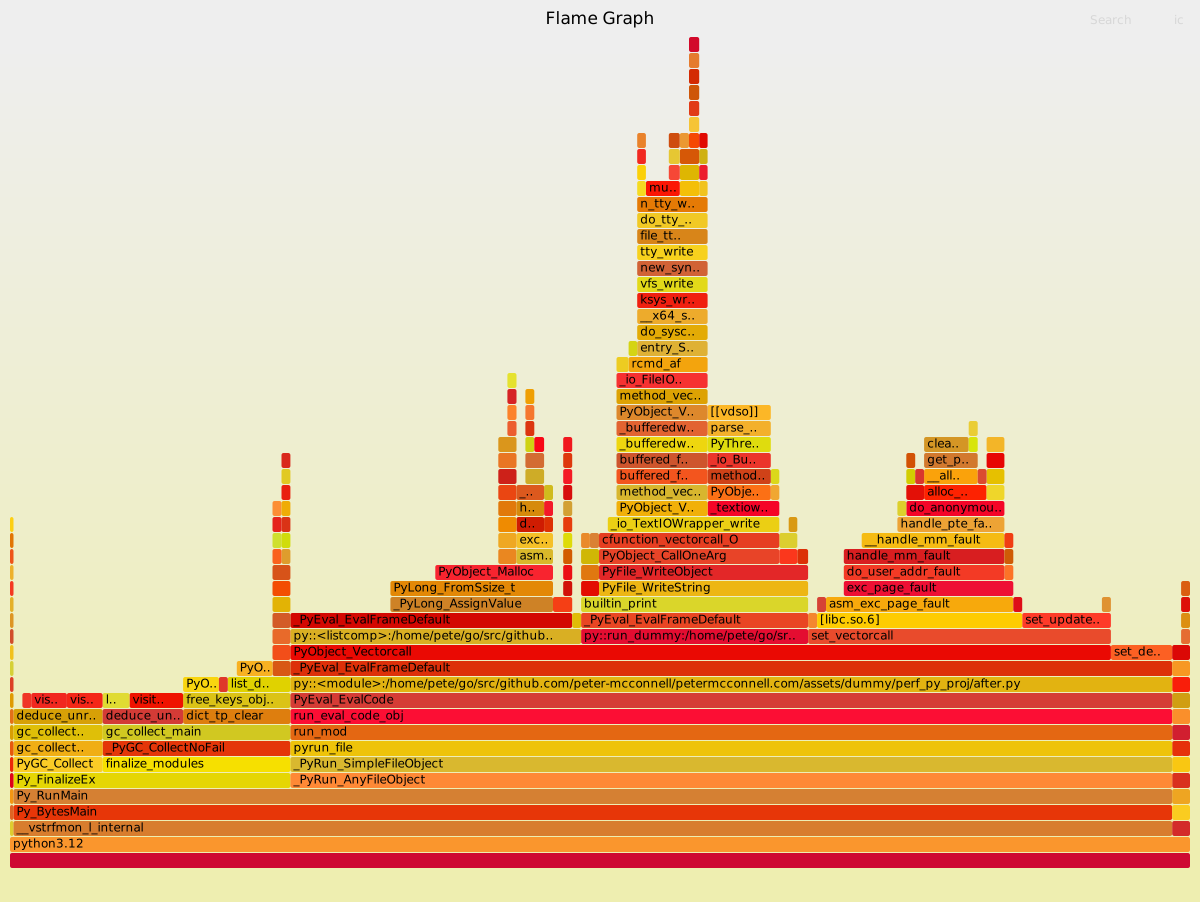
Este é um Flamegraph de aparência muito mais saudável e, como resultado, nosso aplicativo agora é muito mais rápido. O suporte à criação de perfil de desempenho no Python 3.12 traz uma ferramenta tremendamente útil para engenheiros de software que desejam entregar programas rápidos e estou animado para ver o impacto que isso terá na linguagem.
rodada de bônus: o que fazer quando você não consegue acessar o código-fonte?⌗
Às vezes, você não tem acesso ao código subjacente, o que pode dificultar muito a tentativa de entender o que está acontecendo. Felizmente, perf report nos permite visualizar o código desmontado que pode ajudar a pintar uma imagem do que a máquina está realmente fazendo. Este é um primeiro lugar razoável para procurar - tendo a preferir o código-fonte, se puder obtê-lo, pois me permite ‘git culpe’ / visualizar os commits e PRs associados. Para ver isso, você pode fazer o seguinte:
Abra o relatório perf e selecione a linha que nos interessa:
# isso assume que já executamos 'perf record' para gerar perf.data ...
perf report -g -i perf.data
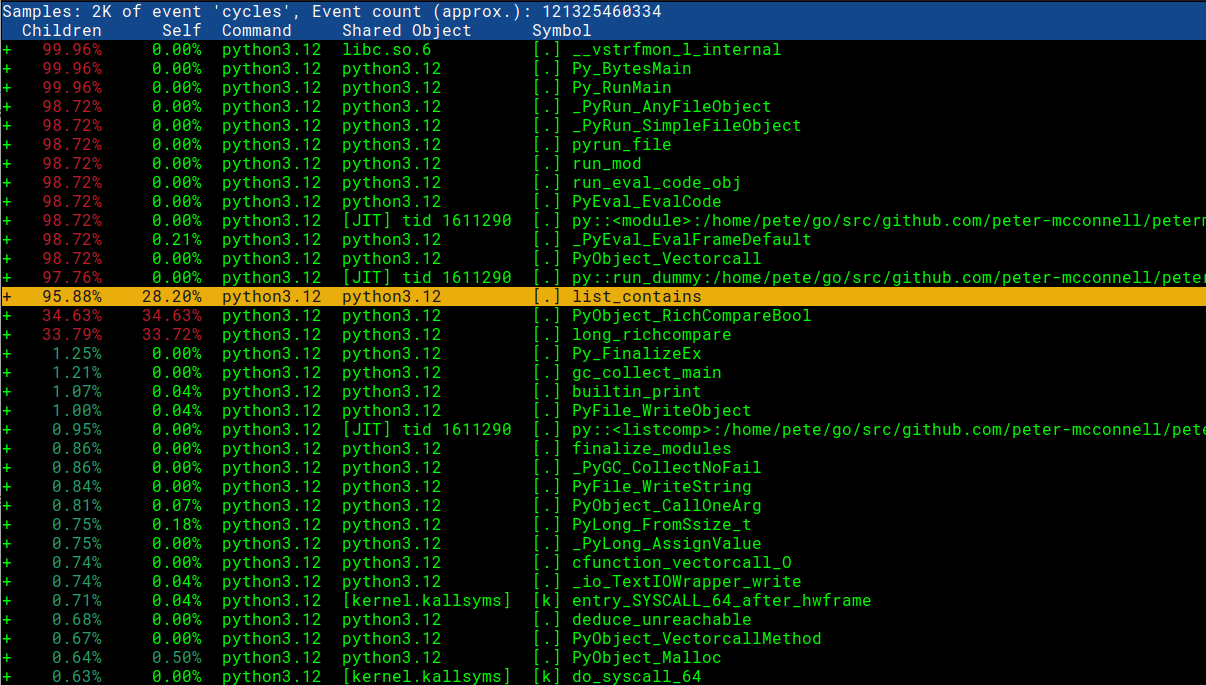
Pressione enter e escolha a opção anotar:
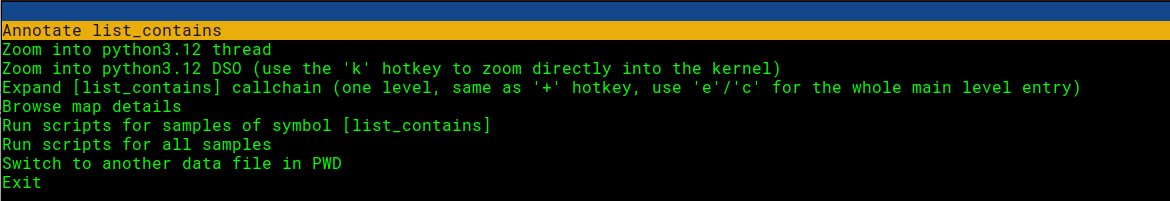
Contemplar! Aqui podemos ver o código C e as instruções da máquina. Super útil! Você pode comparar a captura de tela abaixo com o trecho de código em que estamos interessados: https://github.com/python/cpython/blob/199507b81a302ea19f93593965b1e5088195a6c5/Objects/listobject.c#L440